上周朋友找我吐槽,说本来想装个能跑本地大模型的主机,算下来光一张符合要求的显卡就快顶他三个月房租。他翻了半天参数列表,指着个’HBM3E’的字样问我,这啥玩意儿啊,比显存还金贵?
我当时差点把手里的冰可乐喷出来。
别把HBM当成升级版显存,差远了
很多人第一次看到HBM,第一反应就是“哦,更大容量的显存呗”。
差远了。
普通GDDR显存是沿着显卡PCB板平铺在核心周围,HBM是直接和计算核心“贴贴”,通过硅中介层垂直堆叠在一起,两者的连接距离能缩短到原来的几十分之一。打个最直白的比方:普通GDDR就像你家楼下沿街排开的一排快递柜,你取个包裹得下楼走5分钟;HBM是把一摞快递柜直接嵌在你家门边的墙里,伸手就能拉开柜门取件,而且每层柜子之间留了专门的取件通道,哪怕同时来10个人取件,也不会堵在路口排队。
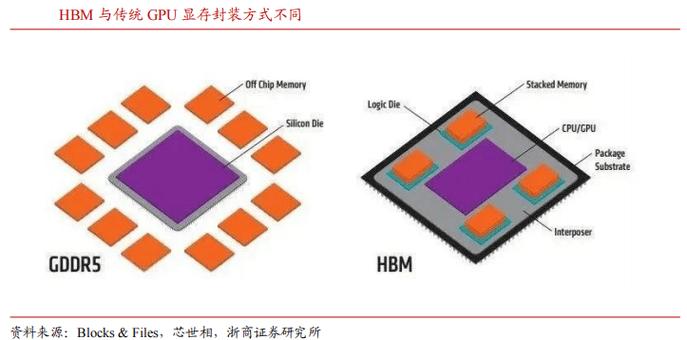
第一次看HBM的制造流程的时候,我真的倒吸一口凉气。这哪是做芯片啊,这是在头发丝上搭千层楼。一层硅片薄到只有几微米,摞个8层、12层,每层之间的对准误差不能超过头发丝直径的几十分之一,稍微歪一微米,整片芯片直接报废。为了不让这些叠起来的芯片积热死机,工程师还得在每层硅片上打满微型的导热微孔,让散热介质能直接钻进每一层芯片中间带走热量。这工艺难度,良产能高才怪。
你平时刷的AI内容,全靠HBM扛着
别觉得这东西离普通人很远。你刷短视频刷到的AI生成的国风写真,你用AI写周报生成的通顺段落,你跟AI聊天的时候它不会卡半天才蹦一个字,这些你觉得理所当然的流畅体验,背后全是HBM在扛。
之前我试过拿家里闲置的老显卡跑7B参数的本地大模型,那显卡用的是普通GDDR6显存,生成一段话要卡个三四秒,跟十几年前拨号上网的速度似的,我盯着屏幕等的功夫都能把那段话手动敲完。后来借了朋友一张带HBM的显卡试了下,字是顺着屏幕往外冒的,那种流畅度,就像从挤早高峰三号线的沙丁鱼罐子里,换到了开着空调的专车后座。
说穿了,大模型跑起来最耗的不是算力,是“数据搬运”的速度。大模型动辄几百亿个参数,全要从显存里塞给计算核心去运算,如果像普通显存那样离核心远,搬数据的速度比计算的速度慢10倍,那显卡上堆再多的计算核心也是白搭——就像你请了个国宴级大厨,结果负责买菜的人半小时才拎回来一把青菜,你就算大厨手艺再好,也做不出满汉全席对吧。

别信那些说HBM马上要白菜价的鬼话
刷数码内容的时候,总能看到博主说“明年HBM产能上来,AI显卡肯定大降价”。说实话,我第一次刷到的时候也信了,直到去年跟在半导体厂做了快十年工艺的学长吃火锅,他给我泼了满满一杯冰酸梅汤。
他说HBM的产能瓶颈,根本不是建几个新厂房就能解决的。就像你能快速盖好多栋高层住宅楼,但是你找得到那么多能在纳米级精度下做芯片对准操作的工程师吗?而且现在所有能量产合格HBM的工厂,产能早就被那些做AI服务器的大厂包圆了——人家签的都是三年起步的长单,价高量足,凭什么优先把产能让给面向个人消费者的显卡啊?
我那个等显卡降价等了半年的朋友,就是听了博主的话,一直憋着没下手,结果呢?之前看中的型号不仅没降价,还因为产能挤不出来断货了,他悔得拍大腿,说早知道当初咬咬牙就买了。
上周跟他一起在路边吃烤串,他咬着烤筋突然反应过来,说其实算算账也不亏——他现在用本地大模型帮他写项目脚本,省下来的加班时间,大半年也能把显卡钱赚回来了。风一吹,烤串的烟飘得满街都是,他盯着手机里刚生成的脚本框架,突然觉得这两万块花的好像也没那么冤。
其实哪有什么高科技是飘在半空中的啊。你平时摸鱼用的AI绘图,你赶方案用的生成式助手,这些你觉得理所当然的顺畅体验,背后都是HBM一层一层摞起来,在显卡板上看不见的角落,给你扛着所有的数据流量而已。