你有没有过这种经历?
在淘宝搜了“露营灯”之后,第二天首页就开始给你推帐篷、折叠椅、卡式炉,甚至还有防潮垫。
你心里一凉——它怎么知道我最近在攒装备?
其实这背后,除了推荐算法,还有一套非常关键的东西在默默运转。它叫知识图谱。听起来特别学术,像是哪个实验室里跑出来的名词。但你已经被它伺候了好多年了,只是从来不知道它叫什么。
一个让机器“看懂关系”的笨办法
咱们先放下概念,想想人是咋认东西的。
你看到一个杯子。你不会只记住一个孤零零的“杯子”。你脑子里会连带出一堆东西:它是用来喝水的,一般放桌上,旁边可能还有茶叶罐,洗它要用海绵,摔了会碎,玻璃杯比塑料杯更容易碎……
这些“关系”,才是你真正理解“杯子”的原因。
但机器不这样。机器最擅长干的事,是把东西当成一个个独立的条目存起来。比如“杯子”是一个编号,“水”是另一个编号。你问它“杯子和水有关系吗”,它只会去翻有没有一条记录写着“杯子-装-水”。要是没有,那就是没有。
知识图谱干的事,就是帮机器把这些线连起来。
它把世界上的人、事、物都看成一个个“点”,然后在这些点之间画上各种各样的“线”。这条线可能是“属于”,那条线可能是“位于”,还有的是“产生于”。当点足够多、线足够密的时候,机器再看一个东西,就不再是一个孤立的关键词了,而是一张网上的某个节点。
对,就是这么个思路。
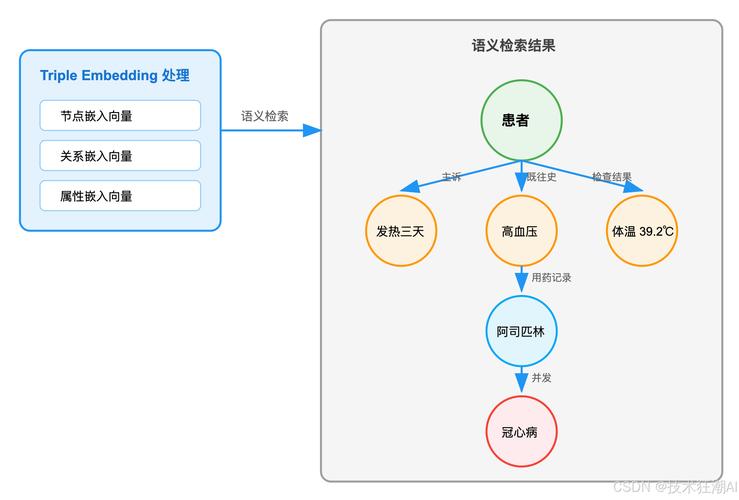
我第一次把这个逻辑搞清楚的时候,脑子里蹦出来的画面特别土——就是小时候玩的那种连线画。你顺着数字把点连起来,最后发现是一头大象。每个数字本身毫无意义,但连起来之后,图案就出来了。
知识图谱就是提前帮机器连好了线,只是那些数字变成了“周杰伦”,线变成了“演唱了”“出生于”“合作过”。
你搜“苹果”的时候,它到底看到了什么

来,做个思想实验。
你去搜索引擎里敲“苹果”这两个字。它面临的第一个问题——你到底在找什么?
是水果那个苹果,还是手机那个苹果?是电影《苹果》,还是某个人外号叫苹果?
没有知识图谱的时候,搜索就是文字匹配。它只会看哪个网页里“苹果”这两个字出现得多、出现得靠前,然后一股脑塞给你。你搜水果,结果前十页全是手机发布会新闻,能把人急死。
有了知识图谱之后,机器开始知道:
苹果——是一种水果——属于蔷薇科——长在树上——可以吃——富含维生素C
苹果公司——是一家科技公司——总部在加州——创始人是乔布斯——卖手机和电脑
这两条链路,彼此是分开的。当你在搜索框里打了“苹果”之后,如果还打了“热量”或者“减肥”,它就会往第一条链上靠。如果你打了“发布会”或者“手机”,它就会往第二条链上靠。
这不是它变聪明了。是你每一次搜索,都在无意中给它的这张网,又添了一条新的线索。
说白了,你每天都在给知识图谱打工,而且还没工资。
别把知识图谱想成万能灵药
这里我得泼一盆冷水。
知识图谱这东西,能力边界其实挺明显的。它最擅长的事,是处理那些结构清晰、关系明确的东西。比如“某个人去了某个地方”“某个公司收购了另一家公司”“某个药品的成分是什么”。
这些事实类的东西,一旦进了图谱,查询起来又快又准。
但如果你问它一些很虚的东西,比如“什么样的人适合做朋友”“这部电影到底好不好看”“为什么我最近总是不开心”——它多半会卡壳。因为这些东西没法用“点—线—点”那种简洁的结构来描述。你说“适合做朋友”,这怎么拆?拆成性格好、靠谱、聊得来?那性格好又怎么定义?一层一层往下切,切到后面你会发现,人类自己都说不清。
所以那些宣传“知识图谱能理解人类全部知识”的说法,听听就好。它更像一本被拆散了又重新整理过的百科全书,条目之间有了链接,但链接的性质非常依赖当初建它的人怎么设计。
说到这个,就不得不提另一个容易混淆的事。
很多人把知识图谱和“语义网”或者“大数据”混着说。其实不太一样。大数据解决的是量的问题,知识图谱解决的是关系的问题。一个管多少,一个管怎么连。你有一亿条数据,但它们彼此没连线,那机器还是看不懂。反过来,只有一千个点,但连线连得特别巧妙,那在这个小范围内,机器反而能做出很聪明的推断。
这也是为什么很多公司做知识图谱,最后发现难点不在于把数据灌进去,而在于到底该在谁和谁之间画线,以及画一条什么性质的线。这个设计环节,目前还是得靠人对业务的理解。纯靠机器自动抽取?抽出来的线经常离谱到你怀疑人生。
我听过一个做电商的人吐槽。说他们早年搞自动抽取,结果系统把“鼠标”和“鼠标垫”连了一条“相似”的线,这没问题。但后来又连了一条——把“鼠标”和“奶酪”也连上了,因为某篇科普文章里写“老鼠爱大米和奶酪”。
机器一看,老鼠和奶酪有关系,鼠标里有个“鼠”字,那鼠标和奶酪应该也有关系吧?
这个笑话在圈内流传挺广的。好笑归好笑,背后那个问题很真实:知识图谱的质量,极大地依赖于给它喂数据的人以及设计规则的人,到底有没有常识。
它正在悄悄变成你手机里的隐形基础设施
你现在打开地图App,搜一家餐厅。它会告诉你:营业时间、人均价格、附近停车场、地铁怎么走、招牌菜是什么、别人拍了什么照片。
这些信息来自不同的地方。营业时间可能来自商家自己填的,价格来自用户点评,停车场来自另一个数据源。它们本来互不相干。但在后台,这些信息通过知识图谱被串起来了——餐厅作为一个实体,和它的属性、和周边的交通设施、和用户的评价内容,都连上了线。
你看到的是简洁的一屏信息。但屏幕背后那张网,庞大得吓人。
再比如你手机里的语音助手。你问它“明天下午三点提醒我给张总发邮件”。它能听懂,是因为它把“明天”“下午三点”“提醒”“张总”“发邮件”这几个概念之间的关系理清楚了。谁对谁做什么,在什么时间做。这些关系,就是知识图谱在支撑。
还有电商平台的“买了这个的人还买了什么”,视频网站的“看过这个视频的人也在看”,背后都有它的影子。
说实话,这东西之所以叫“知识”图谱,而不是“数据”图谱,可能就是为了强调——它关心的不是你有多少数据,而是数据之间有没有形成有意义的连接。一堆沙子堆在一起,还是沙子。但沙子按照特定结构排列,可以变成芯片。
当然,芯片也会出bug。知识图谱也一样。它会出错,会过时,会有偏见。比如早期某些图谱里,和“护士”关联最多的词是“女性”,和“程序员”关联最多的词是“男性”。这不是图谱故意歧视,而是它照搬了训练数据里的现实偏差。
所以说到底,知识图谱是一面镜子。它照出来的,是我们自己组织知识的习惯,也包括我们习惯里那些不太好的部分。
下次再看到搜索结果里那些整整齐齐的信息卡片,或者刷短视频时那个“你可能还想看”的推荐,你可以想想背后那张网。那上面,有无数个点,和无数条线。
而你刚才那次点击,可能又给其中一条线,加了一点重量。